업무 자동화2026.09.16읽는 시간 11분
AI 문서 인식, 손글씨도 읽을까? 5분 판단 기준
손으로 쓴 문서를 AI가 어디까지 읽고, 어디부터 사람이 검토해야 하는지 정리했습니다.
—VIEWS
—LIKES
—SAVES
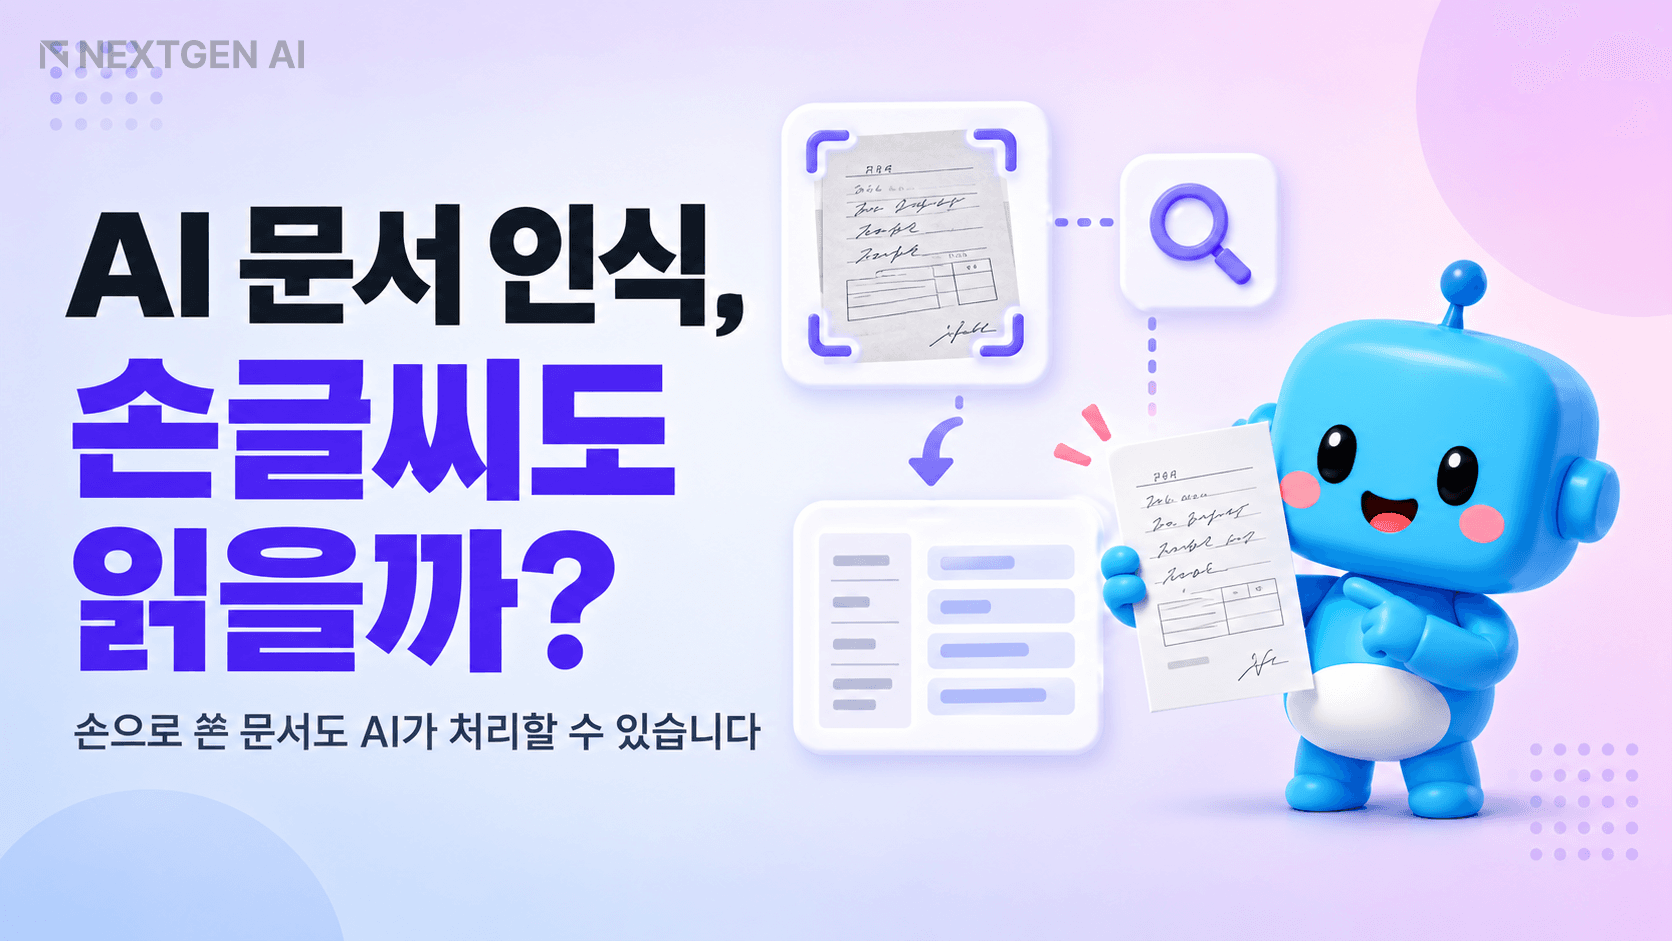
손으로 쓴 문서를 AI가 어디까지 읽고, 어디부터 사람이 검토해야 하는지 정리했습니다.
현장 점검표를 받아 엑셀에 다시 입력합니다. 회의 중 적은 메모를 보고서로 옮깁니다. 서명이 들어간 신청서를 한 장씩 열어 항목을 확인합니다.
문서는 이미 있는데 사람이 다시 읽고 입력해야 한다면 질문은 하나로 모입니다. "손으로 쓴 문서도 AI가 읽을 수 없을까?"
결론부터 말하면 읽습니다. 다만 "읽는다"가 곧 "업무 데이터가 된다"는 뜻은 아닙니다. 이 글은 AI 문서 인식이 손글씨를 어디까지 처리하는지, 어떤 조건에서 사람 검토가 필요한지, 도입 전 무엇을 확인해야 하는지를 5분 안에 정리합니다.
AI 문서 인식은 사진·스캔·PDF 안의 글자와 문서 구조를 컴퓨터가 다룰 수 있는 데이터로 바꾸는 기술입니다. 글자 위치를 찾아 문자로 변환하는 단계에 더해 표의 칸과 항목·값의 관계까지 함께 분석합니다.
손글씨 처리 여부는 이미 공식 문서에 답이 나와 있습니다. 마이크로소프트는 Azure AI Document Intelligence의 Read 모델이 인쇄된 글자와 손으로 쓴 글자를 모두 추출한다고 명시합니다. 손글씨 OCR 지원 언어로는 영어·중국어 간체·프랑스어·독일어·이탈리아어·일본어·한국어·포르투갈어·스페인어 9개를 밝힙니다. 한국어 손글씨가 지원 목록에 들어 있습니다.
다만 서비스마다 범위가 다릅니다. 아마존 Textract 공식 문서는 인쇄 텍스트를 영어·스페인어·독일어·이탈리아어·프랑스어·포르투갈어 6개 언어에서 처리하지만 손글씨는 영어만 지원한다고 밝힙니다. 한국어 손글씨가 섞인 문서를 다룰 계획이라면 도구 선택 단계에서 이 차이를 먼저 확인해야 합니다.
종이 문서가 업무를 늘리는 원인은 종이 자체가 아니라 사람만 읽을 수 있는 상태로 정보가 갇혀 있다는 점입니다. 현장 점검표에 "설비명 A-12 / 점검 결과 이상 없음 / 다음 점검 10월"이라고 손으로 적혀 있으면 사람은 한 번에 이해하지만 관리 시스템에 넣으려면 누군가 같은 내용을 다시 타이핑해야 합니다.
양식이 여러 종류면 부담이 커집니다. 같은 '점검일'이 어떤 양식에서는 문서 상단에, 다른 양식에서는 표 안쪽에 들어갑니다. 체크 표시와 여백 메모가 섞이기도 합니다. 결국 병목은 읽는 일이 아니라 옮기고 대조하는 일에서 생깁니다. 반복 업무 후보를 어떻게 골라내는지는 반복 업무 자동화 후보 판별에서 따로 다룹니다.
OCR은 이미지 속 글자를 문자 데이터로 바꾸는 단계이고 AI 문서 인식은 그 글자를 항목별 값으로 배치하는 단계까지 포함합니다. 같은 문서를 넣어도 결과물의 형태가 다릅니다.
구분 | OCR(글자 추출) | AI 문서 인식(항목 추출) |
|---|---|---|
결과물 | 줄 단위 텍스트 | 항목명과 값이 짝지어진 데이터 |
표 처리 | 글자만 순서대로 나열 | 행·열 위치와 셀 값 유지 |
손글씨 | 지원 언어 안에서 추출 | 추출 후 어떤 항목인지까지 판정 |
양식이 바뀔 때 | 텍스트는 나오지만 위치 정보가 사라짐 | 항목명 기준으로 값을 다시 찾음 |
바로 시스템에 넣기 | 추가 가공 필요 | 매핑 규칙만 맞으면 가능 |
검토 대상 | 오탈자 | 오탈자와 항목 배치 오류 |
표의 결론은 이렇습니다. OCR까지만 도입하면 타이핑은 줄지만 대조 업무는 그대로 남고, 항목 추출까지 가야 시스템 입력 업무가 줄어듭니다.
손글씨 인식 성능이 실무 판단을 바꿀 만큼 올라온 시점이기 때문입니다. Emerald의 Journal of Documentation에 실린 2025년 연구 「Benchmarking large language models for handwritten text recognition」(arXiv:2503.15195)은 상용·오픈소스 대규모 언어모델을 현대·역사 손글씨 데이터셋에서 비교했습니다. 상용 모델이 별도 학습 없이도 전통적 방식을 앞서는 구간이 있다고 보고했습니다.
같은 연구는 한계도 함께 보고합니다. 모델들은 영어 텍스트에서 강한 성능을 보이지만 영어가 아닌 언어에서는 성능이 떨어지고 스스로 오류를 교정하는 능력은 뚜렷하지 않았습니다. 한국어 손글씨 문서를 다루는 조직이라면 영어 기준 벤치마크 수치를 그대로 자사 기대치로 옮기지 않아야 합니다.
손글씨 문서가 업무 데이터가 되기까지는 네 단계를 거칩니다. 각 단계마다 통과 조건이 다르므로 어느 단계에서 막히는지를 먼저 확인해야 도구 선택이 쉬워집니다.
스캔본이나 사진을 확보합니다. 통과 조건은 글자가 사람 눈으로 또렷하게 읽히는 수준입니다. 기울어짐, 그림자, 접힌 자국은 이 단계에서 걸러야 뒤 단계 오류가 줄어듭니다.
문서에서 글자 위치를 찾아 문자로 변환합니다. 통과 조건은 대상 언어가 해당 서비스의 손글씨 지원 목록에 있는지 여부입니다. 한국어 손글씨라면 서비스 문서에서 지원 여부를 직접 확인합니다.
추출된 글자를 '담당자', '점검일', '금액' 같은 항목에 배치합니다. 통과 조건은 자사 양식 30~50건으로 시험했을 때 항목별 값이 일정하게 채워지는지입니다. 이 단계가 실제 자동화 성패를 가릅니다.
낮은 신뢰도 항목을 사람에게 보내고 나머지는 시스템에 넣습니다. 통과 조건은 검토 대상 건수가 전체 처리량보다 뚜렷하게 적은지입니다. 검토 대상이 대부분이면 자동화 효과는 사라지고 업무만 하나 더 늘어납니다.
항목 종류에 따라 자동화 가능 수준이 다릅니다. 2026년 arXiv 논문 「From Handwriting to Structured Data: Benchmarking AI Digitisation of Handwritten Forms」(arXiv:2604.16504)는 날짜·인쇄체·손글씨 응답이 섞인 실제 의료 양식을 대상으로 프런티어 멀티모달 모델과 오픈소스 모델 17종을 평가했습니다.
항목 유형 | 벤치마크가 보고한 수준 | 실무 운영 방식 |
|---|---|---|
선택형·사전 정의 항목 | 최신 모델 정확도 약 85%, 가중 F1 약 90% | 낮은 신뢰도 건만 표본 검토 |
날짜·수치 형식 항목 | 정확도 중앙값 최고 77%(Claude Sonnet) | 전건 자동 입력 전 규칙 검증 필요 |
자유 기술 항목 | 최상위 모델 단어 오류율 0.50, 문자 오류율 0.31 | 요약·분류 용도로만 활용 |
없는 값 생성(환각) | 최저 환각률 6% | 값이 비어야 할 항목에 별도 확인 |
손글씨 양식에서 선택형 항목은 자동 처리에 가깝게 쓸 수 있습니다. 날짜·금액처럼 형식이 있는 항목과 자유 기술 항목은 검증 규칙과 사람 검토를 함께 두어야 합니다.
계약서 금액, 환자 정보, 결제 계좌처럼 한 건의 오류가 큰 비용을 만드는 항목은 자동 입력 대상에서 분리하는 편이 안전합니다. 문서를 AI에 연결하기 전에 정해야 할 범위·권한·근거 기준은 문서를 AI에 연결하기 전 정할 3가지에 정리돼 있습니다.
다음 중 3개 이상 해당하면 AI 문서 인식을 검토할 시점이고, 5개 이상이면 외부 진단을 먼저 받는 편이 낫습니다.
손으로 작성된 문서를 월 수백 건 이상 받아 처리합니다.
받은 문서를 직원이 다시 시스템에 입력하는 업무가 고정적으로 존재합니다.
문서에서 반드시 뽑아야 하는 항목이 이름·날짜·금액처럼 명확하게 정해져 있습니다.
양식 종류가 스무 가지를 넘지 않고 큰 틀이 유지됩니다.
입력 오류가 발견될 때 되돌리는 비용이 큽니다.
문서 처리 다음 단계 업무(승인·정산·통보)가 문서 때문에 지연됩니다.
AI 문서 인식 도입 비용은 모델 사용료보다 양식 정리와 검토 설계에서 결정됩니다. 아래는 양식 5~10종, 월 수천 건 규모를 기준으로 한 일반적인 구간입니다.
단계 | 기간 | 비용이 커지는 조건 |
|---|---|---|
대상 문서·항목 정의 | 1~2주 | 양식이 부서마다 다르게 관리될 때 |
샘플 30~50건 인식 시험 | 2~3주 | 손글씨 비율이 높고 촬영 품질이 고르지 않을 때 |
항목 매핑·검토 규칙 설계 | 3~4주 | 검토 담당자와 기준이 정해지지 않았을 때 |
기존 시스템 연동 | 2~6주 | 연동 대상 시스템에 입력 API가 없을 때 |
전체 기간은 대체로 2~4개월입니다. 인식 정확도 개선보다 항목 정의와 시스템 연동에서 시간이 더 걸립니다.
인식률만 보고 도입합니다.
글자 인식률이 높아도 항목 매핑이 어긋나면 대조 업무가 그대로 남습니다.
양식을 정리하지 않고 시작합니다.
같은 항목이 부서마다 다른 이름으로 불리면 매핑 규칙이 계속 늘어납니다.
검토 담당자를 정하지 않습니다.
낮은 신뢰도 건이 쌓이기만 하면 처리 대기 문서가 오히려 늘어납니다.
영어 기준 성능 수치를 한국어 문서에 그대로 적용합니다.
손글씨 인식은 언어별 편차가 큽니다.
문서가 월 수십 건 수준이면 자동화보다 입력 양식 자체를 디지털로 바꾸는 편이 빠릅니다. 양식이 매달 바뀌는 조직도 매핑 규칙을 유지하기 어려워 효과가 짧게 끝납니다. 뽑아야 할 항목이 정해지지 않은 상태라면 도구 도입 전에 어떤 값을 어디에 쓸지부터 정해야 합니다.
손글씨 문서를 업무에 쓰려면 글자만으로 부족한 경우가 많습니다. 사진 속 상태를 보고 표 구조를 파악하고 문서에 적힌 문장을 함께 읽어야 판단이 완성되기 때문입니다. AI가 텍스트·이미지·문서처럼 형태가 다른 정보를 함께 이해하는 방식을 멀티모달 AI라고 부릅니다.
문서 양이 많아질 때 검색과 응답 속도가 어떻게 달라지는지는 문서가 많아지면 AI가 느려질까에서 이어서 볼 수 있습니다.
문서 자동화의 첫 질문은 "어떤 도구를 살까"가 아니라 "우리 문서 중 어떤 항목부터 자동으로 채울까"입니다. 이 질문에 답하면 도구 비교는 훨씬 짧아집니다.
넥스트젠에이아이는 기업 AI 전환(AX) 컨설팅을 수행하며 문서 업무 진단부터 파일럿 설계까지 함께 진행합니다. 전체 전환 흐름은 AX 컨설팅 가이드에서 확인할 수 있습니다. 무료 AX 진단을 신청하면 자사 문서 중 자동화 후보 항목을 먼저 정리해 드립니다.
읽습니다. 마이크로소프트 Azure AI Document Intelligence 공식 문서는 손글씨 OCR 지원 언어로 한국어를 포함한 9개를 명시합니다. 다만 아마존 Textract는 손글씨를 영어만 지원한다고 밝히므로, 도구를 고르기 전에 대상 언어의 지원 여부를 확인해야 합니다.
RELATED · 함께 읽으면 좋은 글