AI 도입 전략2026.09.17읽는 시간 13분
하이브리드 검색은 왜 필요한가? RAG 5분 정리
키워드 검색과 벡터 검색을 합치는 이유, 그리고 합치지 않아도 되는 경우
—VIEWS
—LIKES
—SAVES
키워드 검색과 벡터 검색을 합치는 이유, 그리고 합치지 않아도 되는 경우
"사내 RAG를 만들었는데 왜 제품 코드를 정확히 입력할수록 엉뚱한 문서를 찾을까?", "규정 번호로 물으면 못 찾는데 이건 모델 문제인가?", "검색 방식을 바꿔야 하나, 모델을 더 좋은 것으로 바꿔야 하나?" 사내 문서 검색이나 RAG PoC를 운영하는 팀에서 반복해서 나오는 질문입니다.
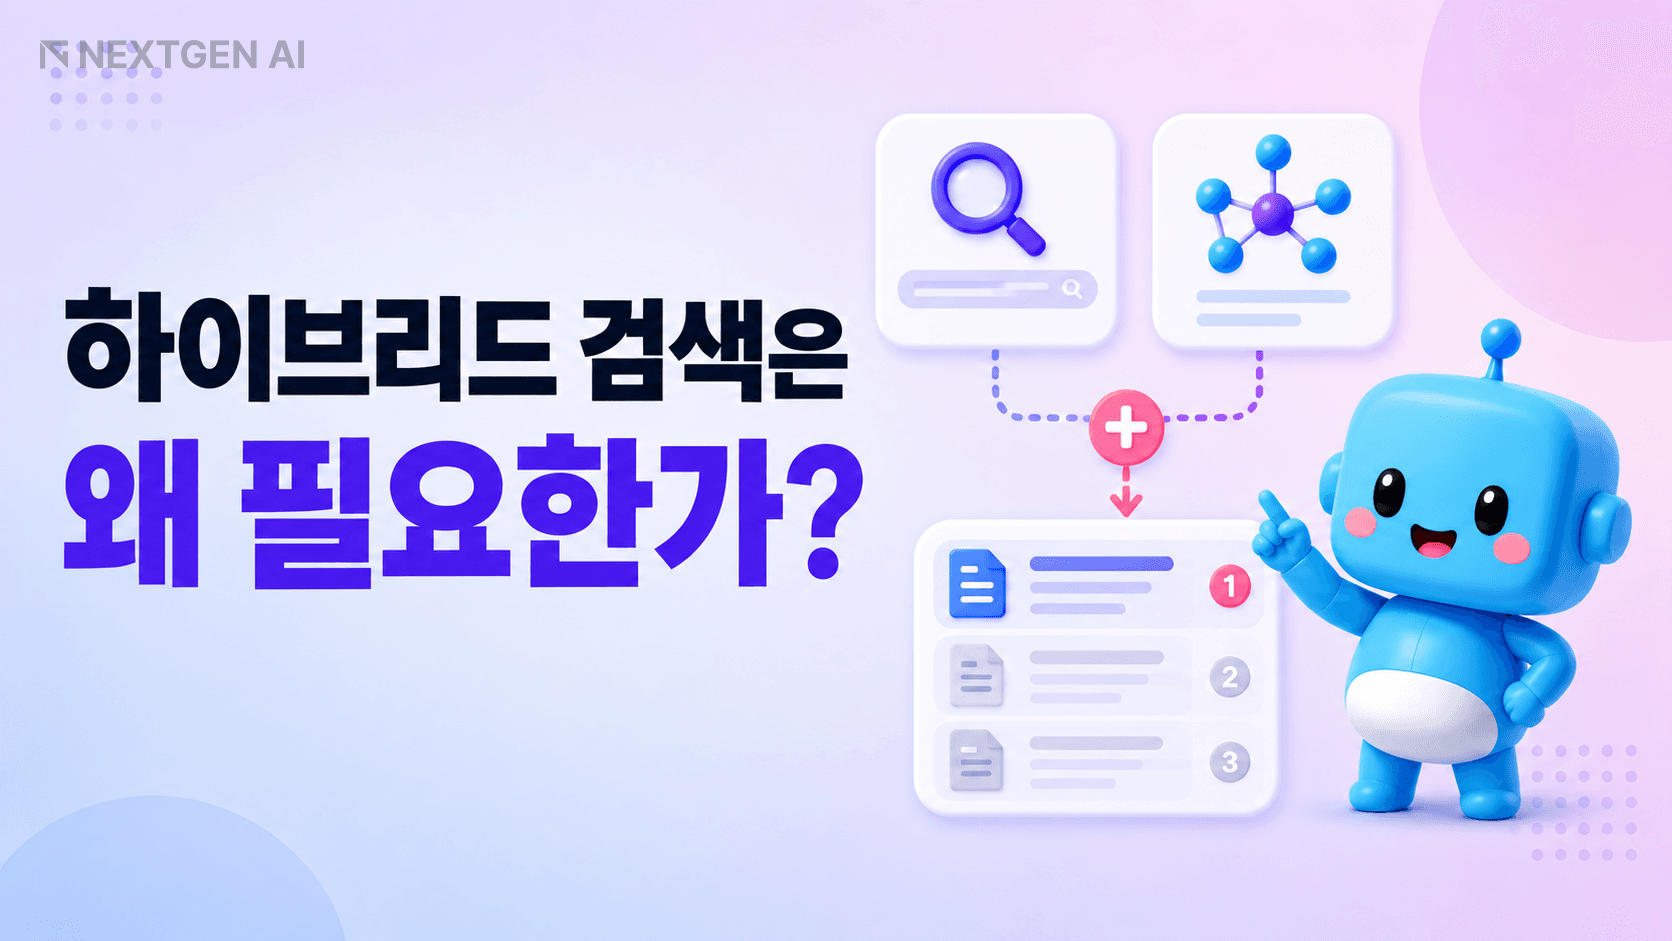
이 질문의 답은 대개 모델이 아니라 검색 단계에 있습니다. 하이브리드 검색은 정확한 단어를 찾는 키워드 검색과 의미가 가까운 내용을 찾는 벡터 검색을 한 질문에 동시에 실행해 서로의 실패 지점을 메우는 방식입니다. 이 글을 읽으면 하이브리드 검색의 정의, 세 가지 검색 방식의 차이, RAG 적용 4단계, 그리고 도입이 오히려 불필요한 경우까지를 5분 안에 구분할 수 있습니다.
하이브리드 검색은 같은 질문을 키워드 검색과 벡터 검색에 동시에 보내고 두 결과를 하나의 순위로 합쳐 상위 문서를 고르는 검색 방식입니다. Microsoft는 Azure AI Search 공식 문서에서 하이브리드 질의를 "두 개 이상의 질의가 병렬로 실행되고 각각의 순위 결과가 하나의 결과 집합으로 병합되는 방식"으로 설명합니다.
키워드 검색의 표준 알고리즘인 BM25는 질의에 들어간 단어가 문서에 얼마나 중요하게 등장하는지를 계산해 순위를 매깁니다. 제품 코드 ERR-1024, 장비 모델명 NGX-240, 계약 조항 번호처럼 문자열 자체가 곧 의미인 질문에서 BM25는 강합니다. 반대로 문서에는 "연차 이월"이라고 적혀 있고 사용자는 "휴가를 다음 해로 넘길 수 있나요"라고 물으면, 겹치는 단어가 없어 BM25는 그 문서를 상위에 올리지 못합니다.
벡터 검색은 질문과 문서를 임베딩(문장의 의미를 숫자 좌표로 바꾼 값)으로 변환한 뒤 좌표가 가까운 문단을 찾습니다. 문서에 "연차 이월"이라고만 적혀 있어도 "남은 휴가를 내년으로 넘길 수 있나요"라는 질문과 연결할 수 있습니다. 대신 벡터 검색은 SKU·사번·규정 번호처럼 의미보다 정확한 표기가 중요한 질의에서 비슷해 보이는 다른 문서를 상위에 올리기 쉽습니다.
BM25는 같은 뜻의 다른 표현을 놓치고, 벡터 검색은 정확히 일치해야 할 고유 표기를 놓칩니다. 두 방식의 약점이 겹치지 않기 때문에, 한쪽이 놓친 문서를 다른 쪽이 건져 올릴 여지가 생깁니다. 하이브리드 검색이 성립하는 근거는 "두 방식을 합치면 더 좋다"는 직관이 아니라 이 실패 지점의 비대칭입니다.
세 검색 방식은 문서를 고르는 판정 기준이 다릅니다. 그래서 잘 처리하는 질문 유형과 실패하는 방식도 다릅니다.
구분 | 키워드 검색(BM25) | 벡터 검색 | 하이브리드 검색 |
|---|---|---|---|
판정 기준 | 질의 단어가 문서에 등장하는 빈도와 희소성 | 질문과 문서 임베딩의 좌표 거리 | 두 순위를 RRF로 합친 최종 순위 |
강한 질의 |
| "휴가 이월되나요" 같은 자연어·동의어 질문 | 코드 질문과 자연어 질문이 섞인 사내 검색 |
약한 질의 | 문서와 다른 표현으로 물을 때 | 고유 번호·약어를 정확히 맞춰야 할 때 | 질문 유형이 한쪽으로 쏠린 단순 검색 |
준비 작업 | 형태소 분석기·동의어 사전 | 임베딩 모델 선택·청킹·벡터 인덱스 | 인덱스 두 벌 + 결합 파라미터 조정 |
실패 방식 | 관련 문서를 아예 못 찾음(누락) | 비슷하지만 틀린 문서를 상위에 올림(오검색) | 결합 비중이 어긋나면 한쪽 약점이 그대로 남음 |
운영 부담 | 낮음 | 중간 | 높음 |
세 방식 중 무엇이 절대적으로 우월한지를 묻기보다, 사내 질문이 어느 열에 몰려 있는지를 먼저 세어 보면 판단이 빨라집니다.
벡터 검색만으로 충분하다는 가정은 공개 벤치마크에서 이미 여러 번 반박됐습니다. Thakur 외 연구진의 BEIR 벤치마크(NeurIPS 2021, arXiv:2104.08663)는 MS MARCO로 학습한 밀집 검색 모델 다수가 학습 도메인 밖 데이터셋에서 BM25를 이기지 못했다고 보고했습니다. 이후 대형 언어 모델 기반 임베딩이 등장하면서 밀집 검색의 성능은 크게 올랐지만 도메인이 바뀔 때 키워드 검색이 여전히 안전판 역할을 한다는 구도는 남아 있습니다.
기업 문서 환경에서는 격차가 더 분명합니다. 2026년 4월 공개된 텍스트·표 혼합 문서 검색 벤치마크(arXiv:2604.01733, 문서 7,318건·질의 23,088건)에서 Recall@5는 BM25 0.644, 밀집 벡터 검색 0.587, 하이브리드 RRF 0.695, 하이브리드에 재순위화를 더한 구성 0.816으로 측정됐습니다. 금융 문서처럼 숫자와 표가 많은 자료에서는 벡터 검색 단독이 오히려 BM25보다 낮았다는 점이 이 결과의 핵심입니다.
이 수치가 모든 회사에 그대로 적용되지는 않습니다. 다만 사내 문서가 계약서·규정·점검표·재무 자료처럼 고유 번호와 표를 많이 포함한다면, 벡터 검색 단독 구성을 기본값으로 두는 선택은 근거가 약합니다. 사내 문서 검색을 처음 설계하는 단계라면 AI 검색 DB가 필요한지 판단하는 기준부터 확인하는 편이 순서에 맞습니다.
하이브리드 검색 적용은 인덱스 구성, 결과 결합, 평가, 재순위화 네 단계로 나뉩니다.
같은 문서 집합에 키워드 인덱스와 벡터 인덱스를 각각 만들고 사용자 질문 하나를 두 인덱스에 동시에 보냅니다. "NGX-240 장비 점검 주기는?"이라는 질문이 들어오면 BM25는 NGX-240이라는 표기를 포함한 문단을 찾고, 벡터 검색은 "장비 점검 주기"와 의미가 가까운 문단을 찾습니다. 두 인덱스는 같은 청크(문서를 쪼갠 조각)를 가리켜야 하며 청크 단위가 다르면 이후 결합 결과를 신뢰할 수 없습니다.
두 검색 결과를 합치는 표준 방법은 RRF(Reciprocal Rank Fusion)입니다. RRF는 척도가 다른 BM25 점수와 벡터 유사도 점수를 억지로 맞추는 대신, 각 결과에서 문서가 몇 위였는지만 사용해 1/(k + 순위) 값을 더해 최종 순위를 만듭니다. Cormack 외 연구진이 SIGIR 2009 논문에서 제안했고 Microsoft Azure AI Search 공식 문서는 상수 k를 60 정도의 작은 값으로 둘 때 성능이 가장 좋았다고 밝힙니다.
평가 없이 하이브리드를 켜면 개선 여부를 확인할 수 없습니다. 현업에서 실제로 나온 질문 30~50개를 모으고 각 질문에 정답 문서를 표시한 뒤, BM25 단독·벡터 단독·하이브리드 세 구성의 상위 5건 적중률을 같은 질문 세트로 비교합니다. 이 비교표가 있으면 "모델이 틀렸다"는 막연한 불만을 "어느 검색 구성이 어떤 질문 유형에서 문서를 놓쳤다"는 확인 가능한 문제로 바꿀 수 있습니다.
재순위화(reranking)는 두 검색이 뽑은 상위 후보 수십 건을 별도 모델로 다시 정렬하는 단계입니다. 텍스트·표 혼합 문서 벤치마크에서 하이브리드 RRF의 Recall@5는 0.695였고 재순위화를 더한 구성은 0.816으로 올랐습니다. 다만 재순위화는 질의당 지연 시간과 비용을 함께 늘리므로, 3단계 평가에서 결합만으로 부족하다는 결과가 나왔을 때 추가하는 편이 안전합니다.
다음 항목 중 3개 이상에 해당하면 하이브리드 검색을 검토할 시점이고 5개 이상이면 벡터 검색 단독 구성으로는 목표 정확도에 도달하기 어렵습니다.
고유 표기가 질문에 자주 등장합니다
제품 코드·규정 번호·약어·사번처럼 정확히 일치해야 하는 표현이 사용자 질문에 반복됩니다.
같은 의미를 여러 표현으로 묻습니다
"연차 이월"과 "휴가 넘기기"처럼 문서 표현과 질문 표현이 자주 어긋납니다.
한 검색 방식에서 반복적인 누락이 확인됩니다
특정 질문 유형에서만 상위 5건에 정답 문서가 들어오지 않습니다.
문서에 표와 숫자가 많습니다
계약서·재무 자료·점검표처럼 표 형태 데이터가 검색 대상에 포함됩니다.
실제 질문 로그를 확보할 수 있습니다
최근 3개월치 사용자 질문을 30건 이상 모을 수 있습니다.
검색 품질을 측정할 담당자가 있습니다
정답 문서를 표시하고 적중률 변화를 추적할 현업 담당자가 지정돼 있습니다.
하이브리드 검색 도입 비용은 검색 엔진 라이선스보다 인덱스 재구성과 평가 세트 준비에 들어가는 인력 시간에서 결정됩니다.
작업 구간 | 소요 기간 | 기간을 좌우하는 요인 |
|---|---|---|
현황 진단·실패 유형 분류 | 1~2주 | 실제 사용자 질문 로그가 남아 있는지 여부 |
평가 세트 구축(질문 30~50개 + 정답 문서 표시) | 2~4주 | 정답 문서를 표시할 현업 담당자의 가용 시간 |
키워드 인덱스 추가·결합 로직 구현 | 1~2주 | 기존 검색 엔진이 BM25와 벡터 검색을 함께 지원하는지 여부 |
파라미터 조정·재순위화 검토 | 1주 | 목표 적중률과 허용 가능한 응답 지연 시간 |
네 구간을 합치면 일반적으로 4~9주가 걸립니다. 기술 통합보다 정답 문서를 표시한 평가 세트를 만드는 작업에 시간이 가장 오래 걸립니다.
평가 세트 없이 켠다
하이브리드로 바꾼 뒤 체감으로만 판단하면 개선인지 후퇴인지 확인할 수 없습니다. 같은 질문 세트로 전후 적중률을 비교해야 판단이 섭니다.
두 인덱스의 청크 단위가 다르다
키워드 인덱스는 문서 전체를 가리키고 벡터 인덱스는 문단 조각을 가리키면 순위를 합칠 기준이 어긋나, 결합 결과가 단독 검색보다 나빠질 수 있습니다.
결합 비중을 한쪽으로 몰아 둔다
벡터 가중치를 지나치게 올리면 하이브리드를 켜고도 제품 코드 질의의 누락이 그대로 남습니다.
검색이 아니라 모델부터 바꾼다
검색 단계에서 정답 문서를 아예 가져오지 못한 상태라면, 더 큰 모델로 교체해도 답변 품질은 개선되지 않습니다.
하이브리드 검색이 모든 RAG의 기본값은 아닙니다.
사내 질문이 대부분 제품 코드나 문서 번호 조회라면 BM25 단독으로 요구 정확도를 채울 수 있습니다. 반대로 사용자가 전부 자연어로 묻고 고유 식별자가 거의 등장하지 않는다면 벡터 검색 단독으로도 충분합니다. 문서가 수백 건 규모이고 질문 유형이 단순한데 인덱스 두 벌과 결합·평가 파이프라인까지 운영하면, 얻는 정확도보다 운영 부담이 커집니다.
그래서 먼저 던질 질문은 "하이브리드를 도입할 것인가"가 아니라 "지금 검색 실패가 정확 일치 문제인가, 의미 불일치 문제인가"입니다. 문서량이 늘면서 속도와 정확도가 같이 떨어지는 증상이라면 문서가 많아질 때 생기는 검색 문제를, 저장 계층부터 다시 볼 단계라면 벡터 데이터베이스의 역할을 먼저 확인하는 편이 낫습니다.
검색 정확도가 낮은 이유는 모델보다 검색·데이터·업무 흐름 쪽에 있는 경우가 많습니다. 텍스트·표 혼합 문서 벤치마크에서는 같은 문서와 같은 질문으로도 검색 구성에 따라 Recall@5가 0.587에서 0.816까지 벌어졌습니다. 모델을 교체하기 전에 어느 단계에서 문서를 놓치는지부터 확인하면, 같은 예산으로 더 큰 정확도 개선을 얻을 수 있습니다.
넥스트젠AI 무료 AX 진단에서는 사내 문서 구조와 실제 질문 유형을 함께 놓고 현재 검색 구성의 실패 지점을 점검합니다. 무료 AX 진단 신청하기
전사 AI 도입 범위와 우선순위까지 함께 정리해야 한다면 AX 컨설팅과 DX의 차이를 이어서 보십시오.
하이브리드 검색은 키워드 기반 검색과 벡터 기반 의미 검색을 같은 질문에 함께 실행하고 두 순위를 하나로 합치는 검색 방식입니다. 정확한 단어 일치와 의미적 유사성을 동시에 활용해, 한쪽이 놓친 문서를 다른 쪽이 건져 올립니다.
RELATED · 함께 읽으면 좋은 글


